In een eerder artikel schreef ik over een vraag die steeds belangrijker wordt naarmate AI zelfstandiger kan handelen:
Als AI iets kan, wat mag het dan zelf beslissen?
Tijdens het verder bouwen en testen van TiepMiep, de typecursus die ik met behulp van AI ontwikkelde, kwam daar een tweede vraag bij:
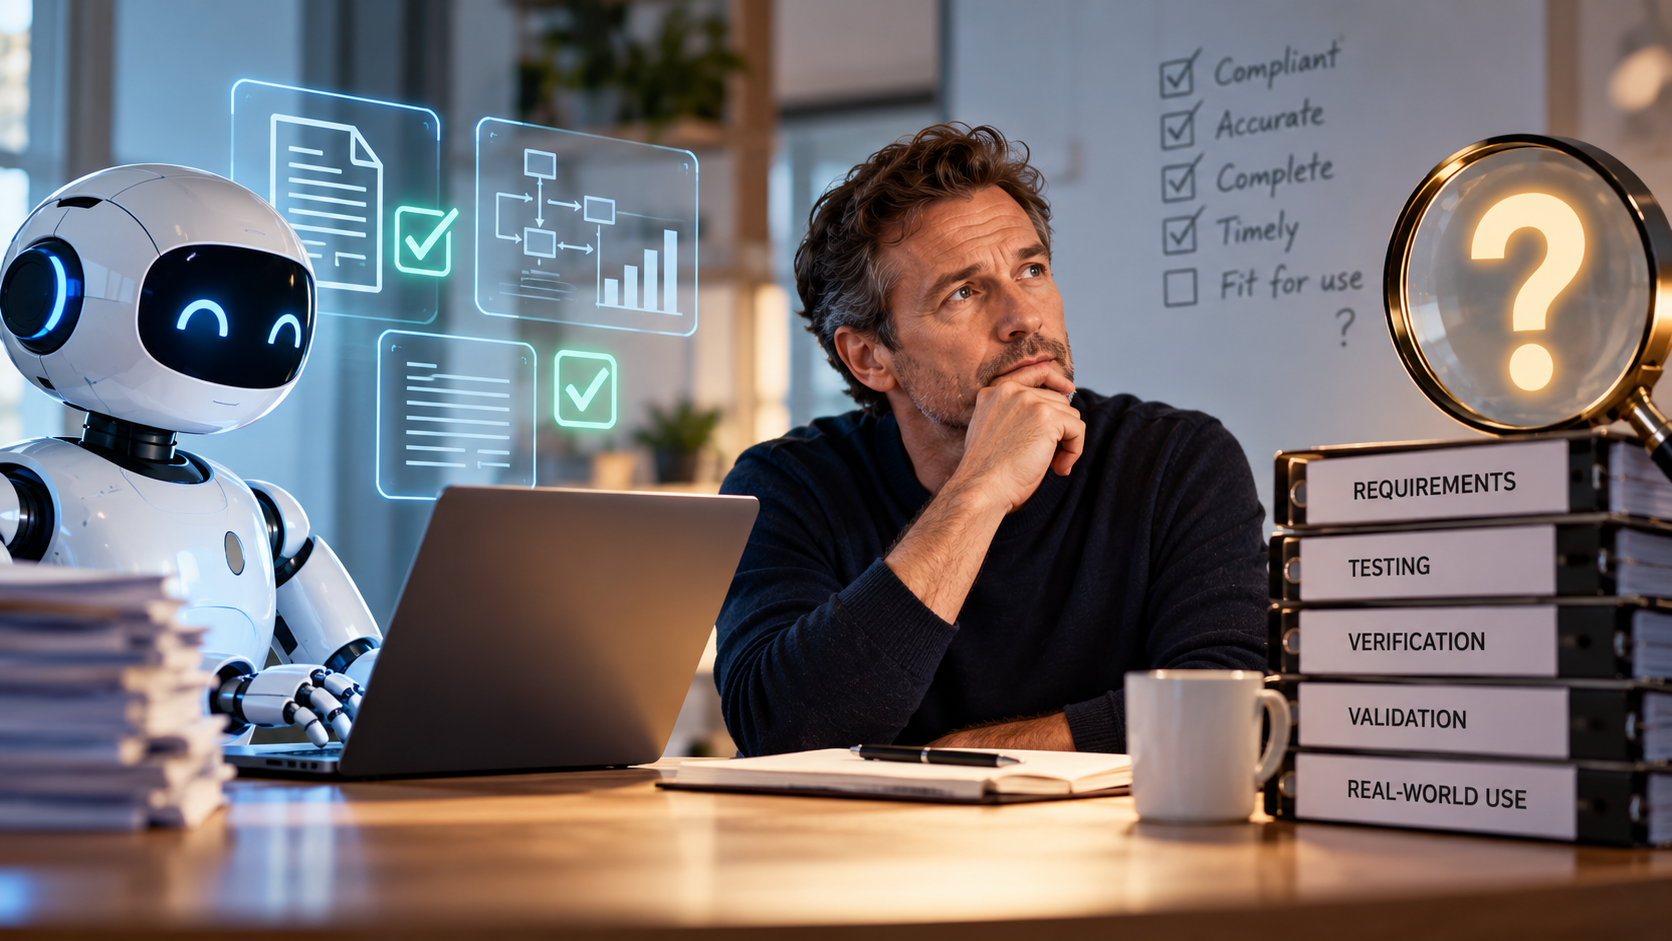
Als AI het werk heeft gedaan, hoe weten we dan of het resultaat goed genoeg is?
Die vraag lijkt misschien technisch. Maar uiteindelijk gaat hij over iets heel menselijks: waarop baseren we ons vertrouwen?
Alles leek te werken
Op een gegeven moment stond er een behoorlijk werkende applicatie.
Er waren lessen, profielen, scores, voortgang, feedback en regels om te bepalen of een leerling een onderdeel voldoende beheerste. Tijdens de ontwikkeling waren bovendien allerlei tests uitgevoerd.
Dat voelde geruststellend.
Tot ik mezelf een simpele vraag stelde:
Wat hebben al die tests eigenlijk bewezen?
Ze lieten zien dat bepaalde onderdelen van de software in bepaalde situaties deden wat we verwachtten.
Maar TiepMiep was niet gebouwd met als uiteindelijk doel om werkende knoppen, scores en lessen te hebben.
Het doel was dat een kind leert blind typen.
En dat hadden de softwaretests helemaal niet bewezen.
Drie vragen die op elkaar lijken
Tijdens het afronden van het project hielp het mij om drie soorten vragen uit elkaar te trekken.
1. Verification — doet het systeem wat we hebben afgesproken?
Werkt de functionaliteit zoals bedoeld? Wordt een resultaat opgeslagen? Gaat een leerling na een geslaagde oefening door naar de volgende les?
2. Process confirmation — kan de bedoelde gebruiker er daadwerkelijk mee werken?
Kan een kind zelfstandig een profiel kiezen, een les starten, de instructie begrijpen en de oefening afronden?
3. Outcome — bereiken we uiteindelijk wat we wilden bereiken?
Kan het kind na de cursus daadwerkelijk zelfstandig en stabiel blind typen in een onbekende Nederlandse tekst?
Dat zijn drie verschillende claims. En iedere claim vraagt om ander bewijs.
Een geslaagde test is geen algemeen bewijs van kwaliteit.
AI maakt bewijs goedkoop
Hier ontstaat iets interessants.
Met AI is het steeds eenvoudiger om tests te bedenken, testcode te schrijven, controles uit te voeren en documentatie te produceren.
Dat is nuttig. Maar het creëert ook een nieuw risico.
We kunnen heel gemakkelijk veel bewijs produceren zonder eerst scherp te hebben wat we eigenlijk willen bewijzen.
Meer bewijs is niet automatisch beter bewijs.
Een map met honderd geslaagde tests kan indrukwekkend ogen. Maar als die tests niet aansluiten bij de belangrijkste risico’s of bij het werkelijke gebruik van het systeem, kan de zekerheid die ze geven kleiner zijn dan de hoeveelheid documentatie doet vermoeden.
Begin niet bij de test
Mijn denkvolgorde is daardoor veranderd.
Niet beginnen met de vraag:
Welke tests kunnen we uitvoeren?
Maar met:
Waarover willen we voldoende zekerheid hebben?
Daaruit volgen een paar eenvoudige vragen:
- Wat proberen we te bereiken?
- Wat kan daarbij relevant misgaan?
- Hoeveel zekerheid hebben we nodig?
- Welk bewijs past daarbij?
Pas daarna wordt testen interessant.
Niet testen omdat het kan. Testen omdat er een relevante onzekerheid is die we willen verkleinen.
En wat als er iets verandert?
Hetzelfde geldt voor regressietesten.
Tijdens softwareontwikkeling is het verleidelijk om na iedere wijziging simpelweg alle bestaande tests opnieuw uit te voeren. Met AI wordt dat technisch steeds makkelijker.
Maar ook daar hoort eerst een denkstap voor.
Wat is er veranderd? Welke bestaande functionaliteit of welk eerder bewijs kan daardoor geraakt zijn?
Daaruit volgt vervolgens gericht opnieuw testen.
verandering → impact → geraakt bewijs → gericht opnieuw testen
Dat is minder spectaculair dan honderden automatische tests uitvoeren. Maar het maakt veel duidelijker waarom een test nodig is.
De rol van Quality Assurance verandert
Voor mij raakt dit direct aan Quality Assurance.
Wanneer AI steeds meer uitvoerend werk kan overnemen, verschuift de menselijke bijdrage.
Niet alleen controleren of activiteiten zijn uitgevoerd, maar vooral vragen:
- Welke claim proberen we te ondersteunen?
- Welk risico proberen we te beheersen?
- Welk bewijs hebben we daarvoor nodig?
- Welke conclusie mag dat bewijs eigenlijk dragen?
AI kan code schrijven, tests uitvoeren, resultaten analyseren en documentatie opstellen.
Maar een grote stapel correct uitgevoerde activiteiten is nog geen goede conclusie.
Wat kon ik uiteindelijk over TiepMiep zeggen?
Aan het einde van deze ontwikkelfase kon ik redelijk onderbouwd zeggen dat er een functioneel geïmplementeerd prototype stond en dat een belangrijk deel van de functionaliteit binnen de geteste situaties was geverifieerd.
Er waren ook enkele observaties van kinderen die ermee werkten.
Maar ik kon niet zeggen dat bewezen was dat de cursus kinderen zelfstandig en stabiel blind leert typen in onbekende Nederlandse tekst.
Daarvoor was het bewijs er simpelweg niet.
En misschien is dat wel de belangrijkste les uit het hele experiment:
kwaliteit betekent niet alleen weten wat werkt. Het betekent ook weten wat je weet, wat je nog niet weet en welke conclusie het beschikbare bewijs werkelijk kan dragen.
Van autonomie naar assurance
Mijn vorige artikel eindigde bij de vraag:
Als AI iets kan, wat mag het dan zelfstandig doen?
Dit experiment voegt daar voor mij een tweede vraag aan toe:
Als AI iets heeft gedaan, welk bewijs hebben wij nodig voordat we erop durven vertrouwen?
De eerste vraag gaat over autonomie.
De tweede over assurance.
En misschien wordt juist dat een steeds belangrijkere menselijke rol in een wereld waarin AI steeds meer werk kan uitvoeren:
bepalen wat ertoe doet, welk bewijs daarbij past en welke conclusie dat bewijs werkelijk kan dragen.