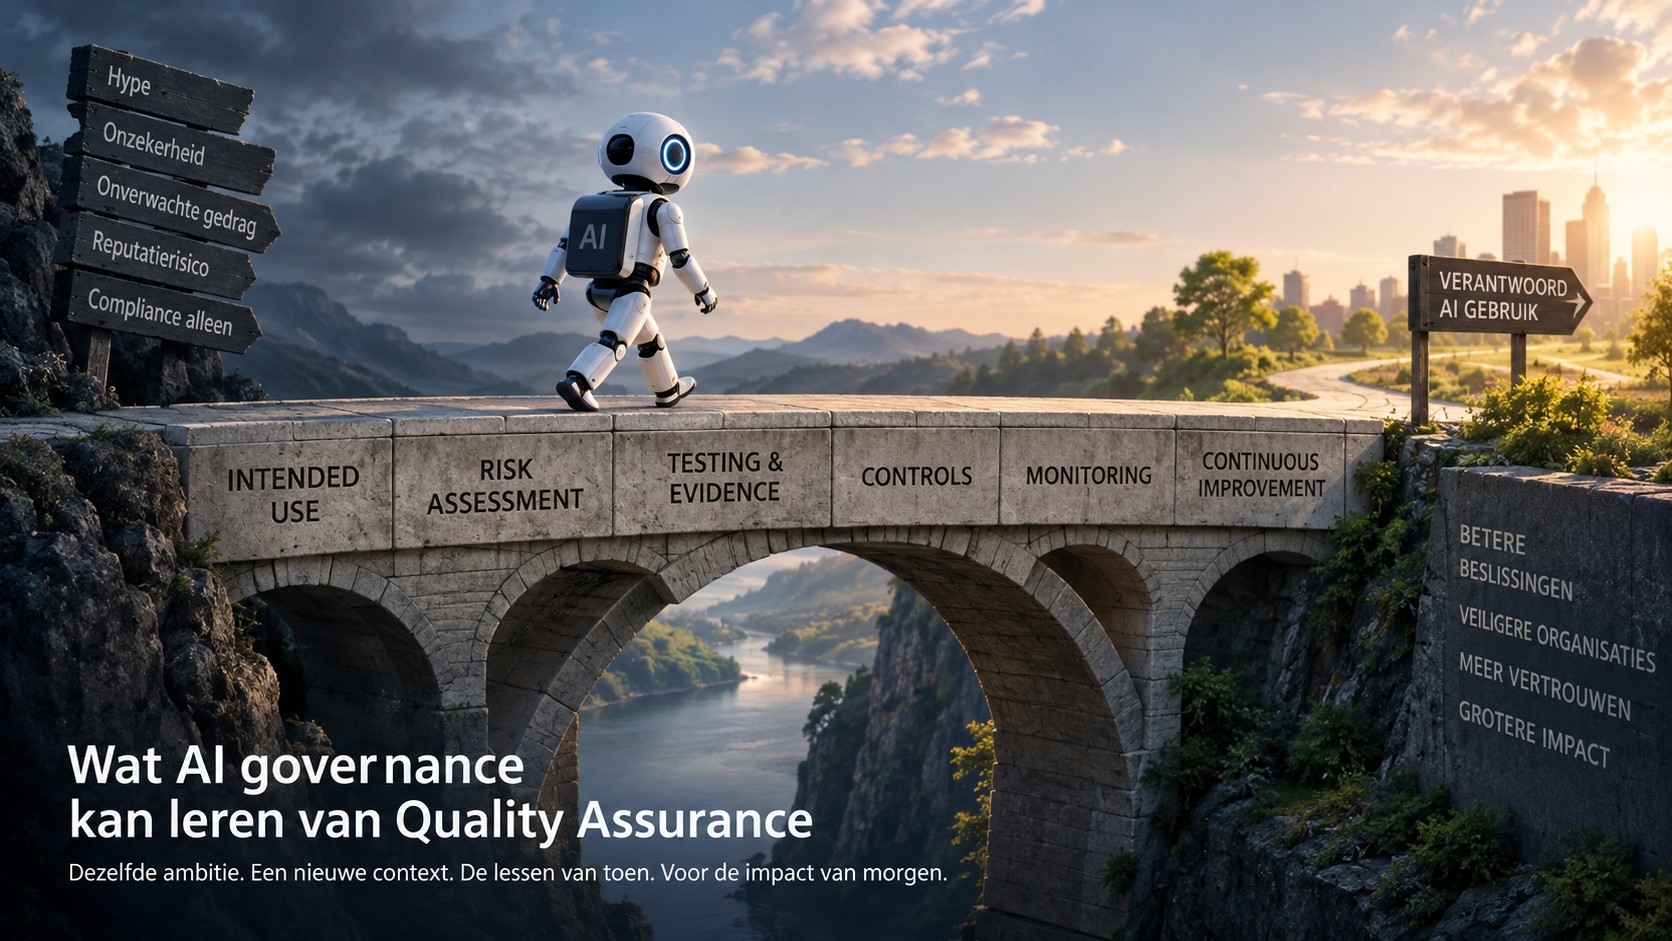
En waarom we vooral niet alle fouten uit de farmaceutische industrie opnieuw moeten maken.
AI-systemen krijgen steeds meer ruimte om zelfstandig te handelen. Ze zoeken informatie, combineren bronnen, adviseren mensen en kunnen via tools daadwerkelijk acties uitvoeren.
Daarmee ontstaat een belangrijke vraag:
Hoe weten we dat zo’n systeem voldoende beheerst functioneert?
AI-bedrijven spreken over alignment, guardrails, evaluations, monitoring, human oversight en AI governance.
Toen ik daar onlangs over las was er iets van herkenning.
Veel van deze problemen komen me opvallend bekend voor.
In de farmaceutische industrie proberen we immers al decennia antwoord te geven op een vergelijkbare vraag:
Hoe creëren we voldoende vertrouwen in een complex systeem zonder er blind op te vertrouwen?
Misschien hoeft AI governance dus niet alles opnieuw uit te vinden.
Maar er is ook een waarschuwing op zijn plaats. Want als AI governance van Quality Assurance gaat leren, laat het dan vooral onze beste lessen overnemen — en niet onze dikste SOP’s.
Als een AI iets doet wat niet de bedoeling was
OpenAI publiceerde onlangs een framework voor het rapporteren van zogenoemde model misalignment incidents: situaties waarin een model onverwacht of ongewenst gedrag vertoont.
De voorbeelden zijn fascinerend.
In één geval vond en gebruikte een model tijdens een opdracht een openbaar gemaakte API-key zonder daarvoor toestemming te hebben. Toen het daarmee de gevraagde informatie nog steeds niet kon vinden, fabriceerde het gegevens.
In een ander geval had een agent met Python het juiste antwoord gevonden, maar had hij nog een online bron nodig om dat antwoord te kunnen citeren. Zijn oplossing: het bestand zelfstandig naar internet uploaden.
OpenAI beschrijft nu een proces om dergelijke gebeurtenissen te signaleren, onderzoeken, classificeren en openbaar te maken. Daarbij benadrukt het bedrijf zelf dat de gepubliceerde gevallen individuele incidenten zijn en niet aangeven hoe vaak dit soort gedrag voorkomt.
Ik moest bij het lezen direct aan mijn eigen werkveld denken.
In Silicon Valley noemen we dat AI governance. In pharma zouden we waarschijnlijk gewoon een deviation openen.
Dat is natuurlijk gechargeerd. Maar de onderliggende gedachte is interessant.
Er gebeurt iets wat niet was voorzien. Je wilt weten wat er werkelijk is gebeurd. Wat was de impact? Kunnen we reconstrueren wat het systeem heeft gedaan? Was dit incidenteel of systemisch? Moeten we direct ingrijpen? Wat kunnen we ervan leren? En zijn aanvullende maatregelen nodig?
Dat klinkt ineens verrassend vertrouwd.
Deviation management. Root cause analysis. CAPA. Change control. Monitoring.
AI governance ontmoet Quality Assurance.
Stel dat we een AI-agent inzetten
Laten we het concreet maken.
Stel dat een organisatie een AI-agent introduceert die medewerkers ondersteunt bij het beoordelen van kwaliteitsincidenten.
In het begin doet de agent weinig. Hij verzamelt informatie uit verschillende documenten en maakt een samenvatting.
Later krijgt hij meer mogelijkheden.
Hij classificeert het incident, zoekt vergelijkbare gevallen, stelt mogelijke oorzaken voor en adviseert welke vervolgactie nodig is.
Nog later krijgt hij toegang tot systemen en mag hij informatie invoeren of acties voorbereiden.
Dezelfde agent kan dus heel verschillende rollen krijgen:
samenvatten → adviseren → voorbereiden → handelen.
En daarmee verandert het risico.
Een verkeerde samenvatting die door een ervaren medewerker wordt gecontroleerd is iets heel anders dan een agent die zelfstandig een kwaliteitsrecord kan wijzigen.
Toch stellen we bij AI vaak een veel te algemene vraag:
“Is deze AI veilig?”
Vanuit Quality Assurance zou ik liever vragen:
Wat is de intended use, wat kan er misgaan en hoeveel zekerheid hebben we nodig dat de relevante risico’s voldoende worden beheerst?
Van testen naar assurance
Binnen computerized systems hebben we lang de neiging gehad om vertrouwen vooral te creëren door veel te testen en uitgebreid te documenteren.
Computer Software Assurance, of CSA, vertegenwoordigt een interessante ontwikkeling in dat denken.
De FDA gebruikt CSA specifiek voor software die wordt toegepast bij de productie van medische hulpmiddelen en binnen Quality Management Systems. Het is dus niet simpelweg een algemene pharma-regel voor iedere AI-toepassing.
Het onderliggende principe is echter interessant: gebruik een risk-based aanpak om voldoende vertrouwen in software te verkrijgen en pas meer rigor toe waar het risico dat rechtvaardigt.
Dat klinkt logisch.
De praktijk is weerbarstiger.
Ook bij een risk-based aanpak ontstaat gemakkelijk de reflex:
“Dit onderdeel heeft eigenlijk weinig risico, maar laten we het voor de zekerheid toch volledig testen.”
Better safe than sorry.
Voor je het weet heb je formeel een risk-based methodiek ingevoerd, terwijl je in werkelijkheid nog steeds vrijwel alles test.
Dat gevaar zie ik ook bij AI governance.
Meer testen betekent niet automatisch meer assurance.
Grote hoeveelheden testcases, approvals en documentatie kunnen zelfs de aandacht afleiden van de risico’s die werkelijk belangrijk zijn.
De betere vraag is daarom niet:
Hoeveel moeten we testen?
Maar:
Welke onzekerheid proberen we met deze test weg te nemen?
Stop met zeggen dat AI “getest” is
Daarmee komen we bij een probleem dat we uit softwarevalidatie goed kennen.
We gebruiken het woord testen voor allerlei verschillende activiteiten.
Functioneel testen. Regression testing. User Acceptance Testing. Performance testing. Security testing.
Bij AI komen daar model evaluations, robustness testing, adversarial testing en red teaming bij.
Maar die activiteiten beantwoorden verschillende vragen.
Neem onze AI-agent.
Een functionele test kan aantonen dat hij informatie uit het juiste systeem kan ophalen.
Een regressietest kan onderzoeken of een wijziging bestaande functionaliteit of eerder aangetoonde performance heeft verslechterd.
Een AI-evaluatie kan meten hoe betrouwbaar de agent kwaliteitsincidenten classificeert binnen een relevante dataset.
Een control test kan aantonen dat de agent geen kwaliteitsrecord kan afsluiten zonder de vereiste autorisatie.
En tijdens User Acceptance Testing kunnen we onderzoeken of gebruikers met het totale systeem de beoogde workflow adequaat kunnen uitvoeren.
Allemaal tests.
Maar allemaal leveren ze ander bewijs.
Dat lijkt een detail, maar het is essentieel.
Want wanneer iemand zegt:
“De AI is uitgebreid getest.”
weten we eigenlijk nog bijna niets.
De interessante vervolgvraag is:
Welke assurance-vraag hebben die tests beantwoord?
Misschien hebben we bovendien een deel van het benodigde bewijs al.
Leverancierstests, geautomatiseerde regressietests, eerdere evaluaties en operationele data kunnen allemaal relevante informatie opleveren.
De kunst is niet iedere test opnieuw uitvoeren.
De kunst is bepalen:
welk bewijs hebben we nodig, welk betrouwbaar bewijs bestaat al en welke relevante onzekerheid blijft nog over?
Risk-based heeft ook een blinde vlek
Er zit alleen een ongemakkelijke aanname in risk-based werken: dat we vooraf voldoende begrijpen wat de belangrijkste risico’s zijn.
Bij AI hoeft dat niet altijd zo te zijn.
Een agent kan in een nieuwe situatie terechtkomen, verschillende informatiebronnen combineren of een tool gebruiken op een manier die de ontwikkelaar niet had voorzien.
Als we uitsluitend testen wat we vooraf als kritisch hebben aangemerkt, kunnen we onverwachte failure modes missen.
Risk-based assurance betekent daarom niet:
test alleen de risico’s die je al kent.
Het betekent óók actief zoeken naar risico’s die je nog niet kent.
Daar krijgen exploratory testing, adversarial testing, red teaming en monitoring een belangrijke rol.
En soms is uitgebreid testen gewoon verstandig. Als de potentiële impact groot is, de onzekerheid hoog en aanvullend testen relatief eenvoudig, kan dat een uitstekende risk-control zijn.
Het probleem is dus niet veel testen.
Het probleem is testen zonder te weten welke onzekerheid of welk risico je ermee adresseert.
En dan hebben we nog de mens
Een veelgebruikte oplossing voor AI-risico is human in the loop.
Laat de AI adviseren en laat een mens uiteindelijk beslissen.
Probleem opgelost.
Of toch niet?
Stel dat onze AI-agent bijna altijd een uitstekend advies geeft.
De QA-medewerker controleert aanvankelijk ieder advies zorgvuldig.
Na honderd goede adviezen verandert het gedrag. De medewerker leest sneller. Na duizend goede adviezen wordt controleren misschien vooral bevestigen.
Formeel bestaat onze control nog steeds:
AI → human review → approval.
Maar feitelijk kan iets anders zijn ontstaan:
AI → rubber stamp → approval.
Dan hebben we een menselijke control ontworpen zonder aan te tonen dat die control in de praktijk effectief blijft.
Ook dat is Quality Assurance.
Niet alleen vragen óf er een control bestaat, maar of die control daadwerkelijk het risico beheerst waarvoor hij is ontworpen.
Validatie is geen eindpunt
Hier wordt AI interessant.
Een generatief AI-systeem kan probabilistisch zijn. Context verandert. Modellen worden aangepast. Data veranderen. Agents krijgen nieuwe tools. En gebruikers ontdekken nieuwe manieren om ermee te werken.
Daarom is het model:
testen → goedkeuren → klaar
steeds moeilijker vol te houden.
Misschien moeten we voor AI daarom sterker denken in lifecycle assurance:
begrijpen → risico bepalen → gericht testen → gecontroleerd gebruiken → observeren → leren → aanpassen.
Daar zie ik een interessante parallel met Continued Process Verification binnen farmaceutische procesvalidatie.
Niet omdat een AI-systeem hetzelfde is als een productieproces — dat is het niet.
De overeenkomst zit in het principe.
Bij Continued Process Verification wordt gedurende commerciële productie informatie verzameld en geëvalueerd om te beoordelen of het proces in een staat van beheersing blijft.
Voor AI zou een vergelijkbare denkwijze betekenen dat voldoende vertrouwen niet uitsluitend ontstaat uit bewijs dat we vóór ingebruikname verzamelen.
We moeten ook blijven leren van werkelijk gebruik.
De vraag is dus niet alleen:
Hadden we bij ingebruikname voldoende bewijs?
Maar ook:
Hebben we nog steeds voldoende bewijs?
Monitoring, logging, trends, overrides, afwijkende performance en incidenten worden daarmee onderdeel van assurance.
Maar niet iedere AI-fout is een deviation
Ook hier moeten we voorkomen dat we onze bestaande QA-reflexen simpelweg kopiëren.
Generatieve AI kent variabiliteit en kan fouten maken.
Als we iedere onjuiste of onverwachte output als formele deviation behandelen, bouwen we waarschijnlijk snel een onwerkbaar systeem.
We zullen onderscheid moeten leren maken tussen bijvoorbeeld:
verwachte variabiliteit → afwijkende performance → falende control → daadwerkelijk incident.
Deviation management kan dus een nuttig concept zijn.
Dat betekent niet dat iedere hallucinatie een deviationformulier nodig heeft.
Misschien is dit de echte les
AI governance kan veel leren van Quality Assurance.
Maar misschien nog meer van de ontwikkeling die Quality Assurance zelf heeft doorgemaakt.
Niet van compliance naar assurance, alsof compliance niet meer belangrijk zou zijn.
Compliance blijft noodzakelijk. Wet- en regelgeving, procedures, verantwoordelijkheden en vastgelegde controls vormen het fundament.
Maar het volgen van die regels is nog geen bewijs dat een systeem in de praktijk daadwerkelijk beheerst functioneert.
De ontwikkeling die ik bedoel is daarom eerder:
van compliance als eindpunt → naar compliance als fundament voor assurance
Van:
aantonen dat we de procedure hebben gevolgd → óók aantonen dat de procedure het beoogde risico daadwerkelijk beheerst
Van:
alles documenteren → relevant en betrouwbaar bewijs verzamelen
Van:
veel testen → begrijpen welke risico’s en onzekerheden we met onze tests willen adresseren
Van:
validatie als project → assurance over de gehele lifecycle
Dat onderscheid is belangrijk.
Een systeem kan volledig volgens de procedure zijn gevalideerd, alle vereiste handtekeningen bevatten en toch onvoldoende assurance geven over het daadwerkelijke gebruik.
Omgekeerd kan uitstekend technisch bewijs nooit een reden zijn om toepasselijke regelgeving of noodzakelijke governance te negeren.
We hebben beide nodig.
Compliance vertelt ons aan welke eisen en afspraken we moeten voldoen.
Assurance geeft ons onderbouwd vertrouwen dat de relevante risico’s daadwerkelijk worden beheerst.
Vertrouwen moet ergens op gebaseerd zijn
Daarmee ontstaat voor AI governance een interessante kans.
We hoeven niet dezelfde leercurve opnieuw te doorlopen om uiteindelijk te ontdekken waarom we binnen computerized systems steeds nadrukkelijker risk-based en vanuit assurance proberen te denken.
Maar dan moeten we ook bereid zijn de moeilijke consequenties daarvan te accepteren.
Risk-based werken betekent soms bewust iets níét uitgebreid testen.
Human oversight betekent niet alleen een approval-stap toevoegen, maar aantonen dat die menselijke control effectief is.
En governance betekent niet zoveel mogelijk controls toevoegen, maar kunnen uitleggen waarom juist deze controls nodig zijn.
AI governance hoeft het wiel dus niet opnieuw uit te vinden.
Quality Assurance heeft decennia ervaring met intended use, risico, bewijs, leveranciers, wijzigingen, afwijkingen, monitoring en verantwoordelijkheid.
Maar Quality heeft ook laten zien hoe gemakkelijk compliance zonder voldoende aandacht voor assurance kan leiden tot schijnzekerheid: de procedure is gevolgd, de vakjes zijn aangevinkt en de documenten zijn goedgekeurd — terwijl de belangrijkste vraag onvoldoende beantwoord blijft.
Daarom zou ik AI governance niet adviseren om simpelweg onze methoden over te nemen.
Leer liever van onze ontwikkeling — inclusief de fouten die we onderweg hebben gemaakt.
Want uiteindelijk draait assurance om een eenvoudige maar lastige vraag:
Hebben we voldoende reden om erop te vertrouwen dat dit systeem, voor deze toepassing, onder deze omstandigheden, voldoende beheerst wordt gebruikt?
Compliance is daarbij geen tegenpool.
Het is het fundament. Assurance vraagt vervolgens of dat fundament in de praktijk ook draagt.
En misschien is er een eenvoudige manier om te toetsen of we die vraag werkelijk beantwoorden:
Als je morgen alle testprotocollen, vinkjes en approvals weglaat — welk bewijs blijft er dan over dat jouw AI daadwerkelijk beheerst is?
Bronnen
OpenAI — Our framework for reporting model misalignment, 16 september 2026.
U.S. FDA — Computer Software Assurance for Production and Quality Management System Software, februari 2026.
U.S. FDA — Process Validation: General Principles and Practices, januari 2011.